数据告诉你人们在哪里离开。它从不告诉你为什么。
我们怎样读完一年的融资消息和 100 个阿拉伯语网站,数字证明了什么、证明不了什么,以及怎样把数据分析当作一种设计方法,用不用 AI 都行。
本页内容
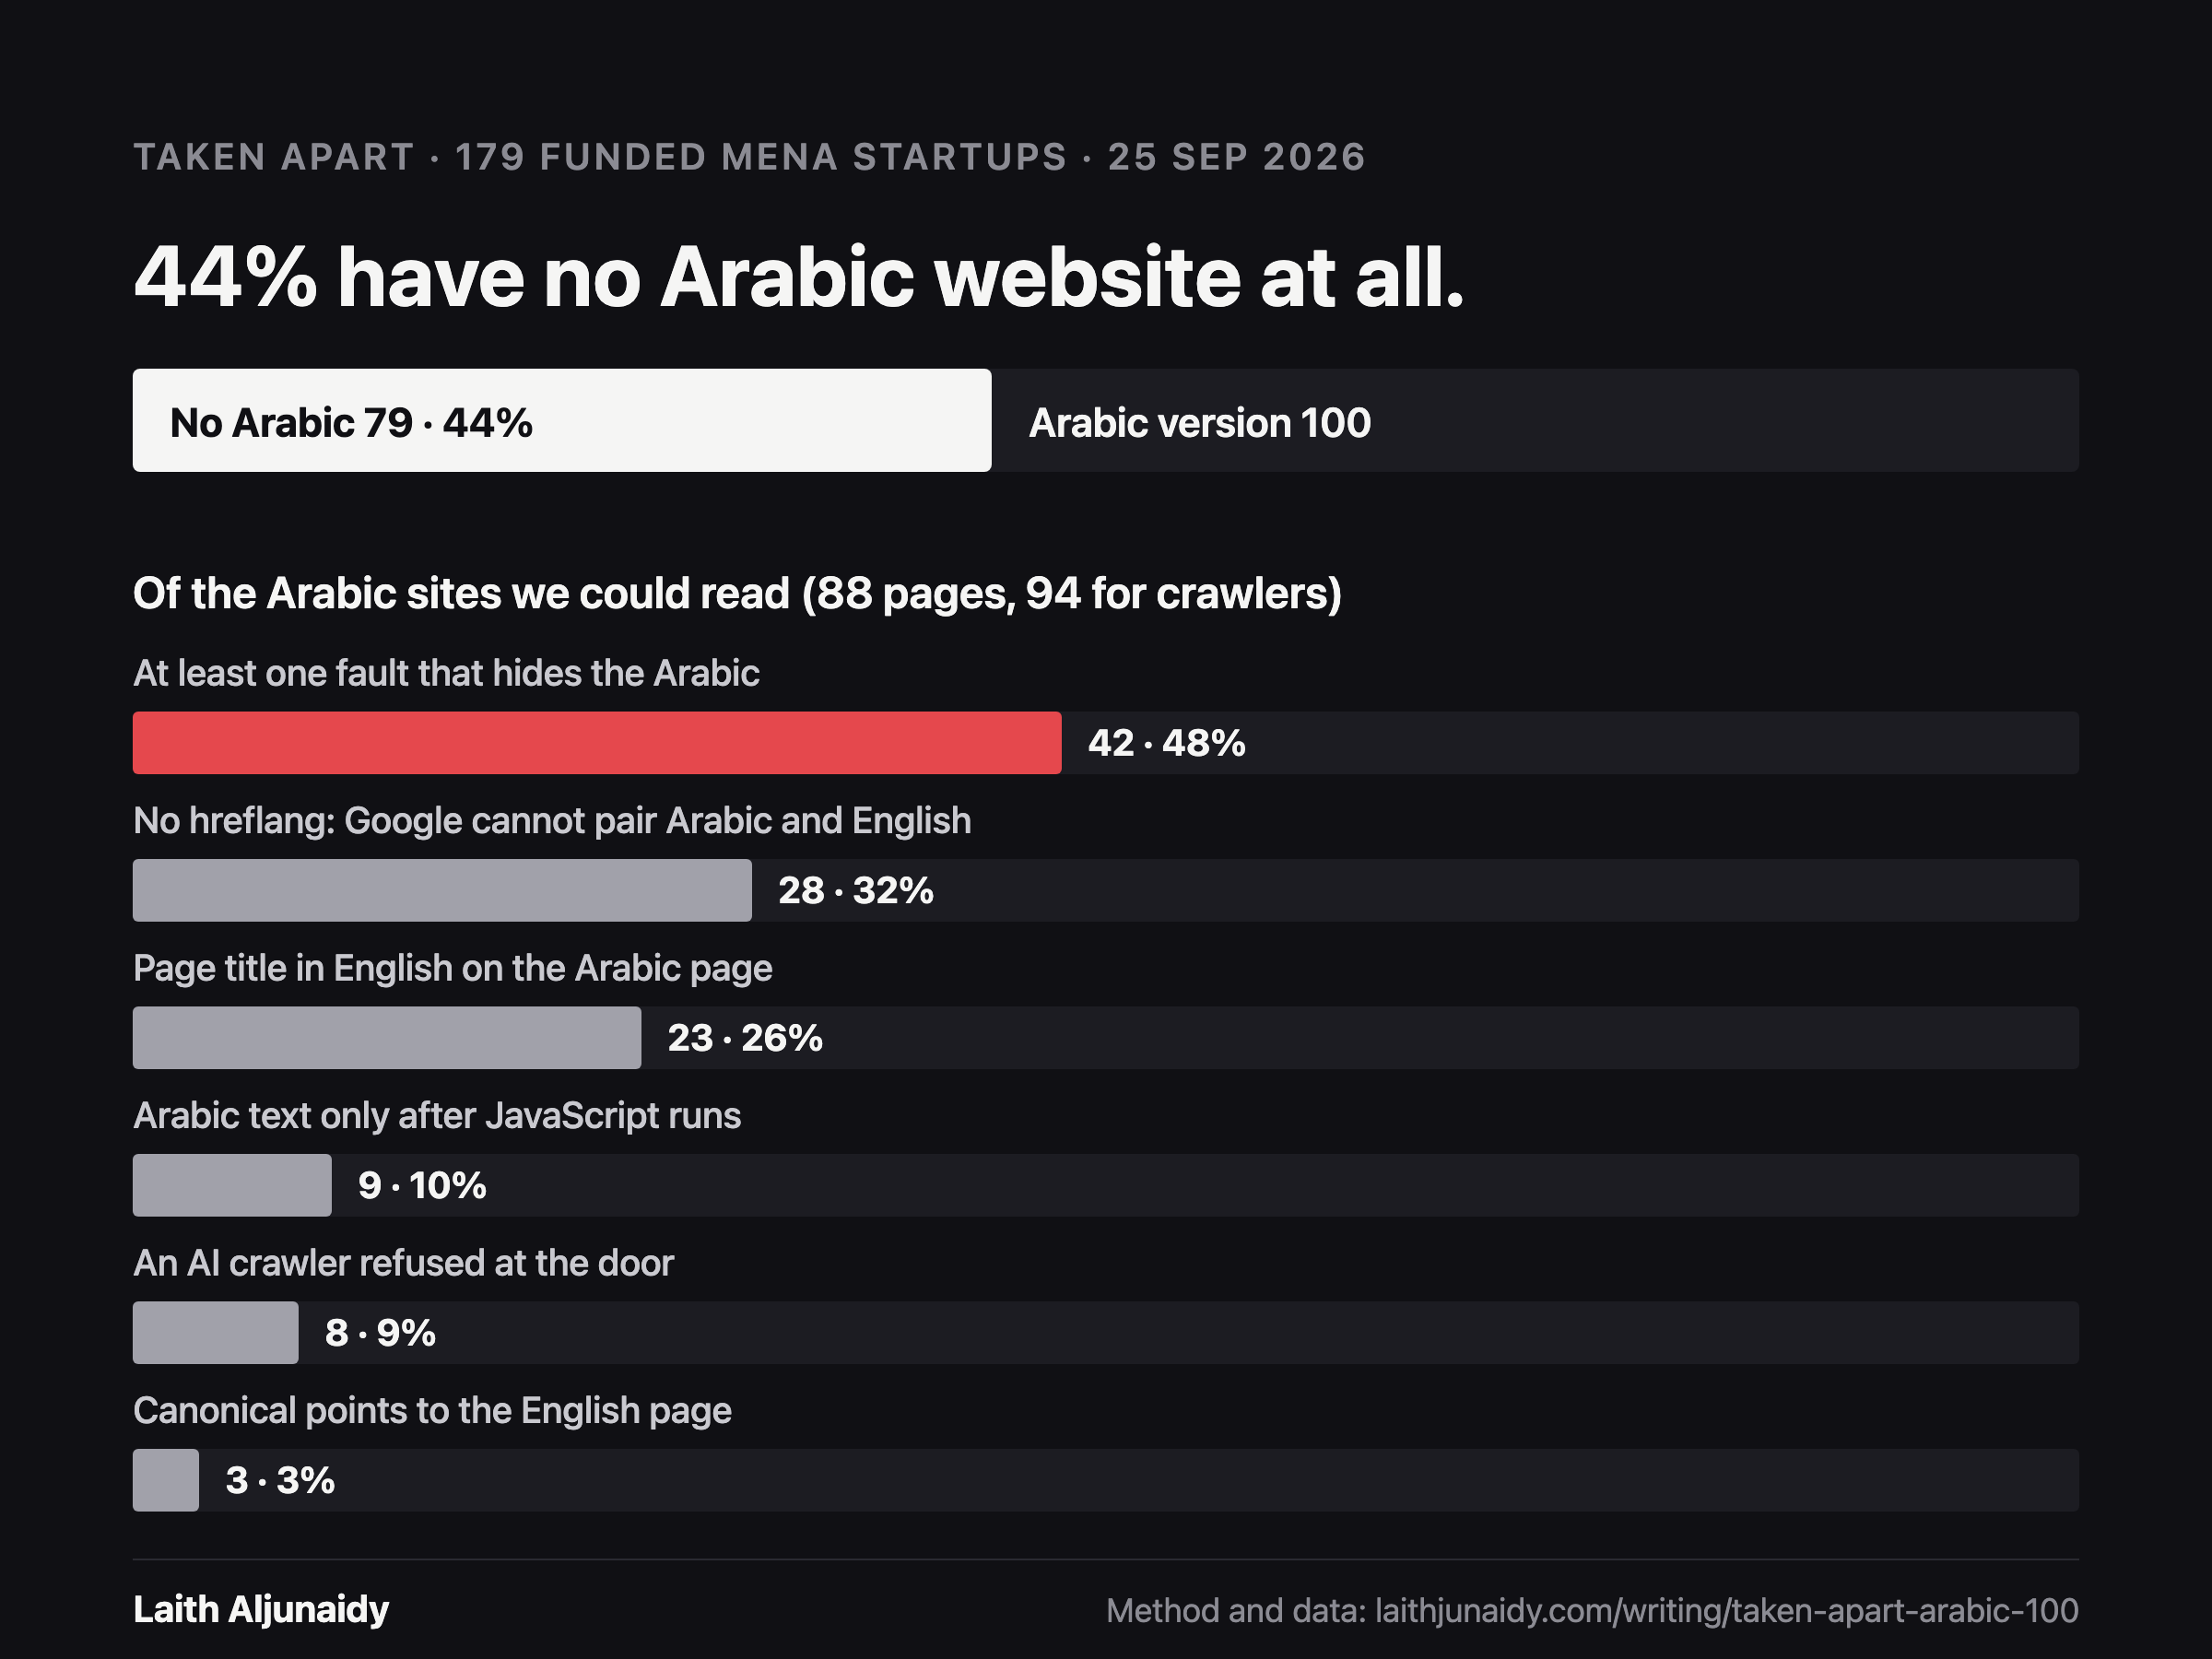
2026 年 9 月 25 日,我发布了《解构》第二期。这个地区 179 家网站可以检查的获得融资的新公司中,79 家根本没有阿拉伯语版本。即 44%。
这个地区的每一位创始人谈到阿拉伯语都说同一句话:当然支持。我想知道这在页面上到底是什么样子,所以不再问,直接去数。一份公开名单,按顺序读,每家公司都检查,不挑选。发布这个结果的那次 commit 把 Claude 列为共同作者。检查脚本、样本和样本选取说明都放在文章旁边,谁都可以重新跑一遍。
这个数字现在是我设计流程指南英文版里 Data analysis 一节的例子。再读一遍,限制就在结果里。数据说,67 家获得融资的 UAE 新公司中有 53 家只用英语展示自己。关于原因,它一个字也没说。创始人是决定这样做、忘了、负担不起,还是从没想过买家读阿拉伯语,它都不说。我能给你的任何原因,都只是看起来像发现的猜测。
这个缺口就是整个方法。数据分析告诉你人们在哪里离开。它从不告诉你为什么。下面讲这次检查实际是怎样做、怎样读的,以及它教给我们怎样在设计里使用数据。
要点
- 数据分析就是在做任何新东西之前,先读已经有的东西:分析数据、销售、客服记录、搜索记录、应用评论、公开数据、过去的研究。这是成本最低的研究,所以排在最前面。
- 它回答在哪里和有多少。它回答不了为什么。为什么来自访谈和观察,数据告诉你该问谁、问什么。
- 在看之前先定下来源和顺序。我们从新到旧读 Wamda 的融资消息,按顺序检查每一家符合条件的公司。没有一家是因为有问题才被选中的。
- 每个数字都带着基数。同样的 79 家公司,是 179 的 44%,也是 184 的 43%。两个都对。去掉分母之后,只有一个还算诚实。
- 测量,绝不猜测。读不到的网站不计入那项检查,并且说明这一点,不去填补。
- AI 让分析变便宜。现在要的能力是检查它:打开原始数据行,重新数一遍,删掉任何背后没有文件的百分比。
UX 研究中的数据分析是什么?
就是在做任何新东西之前,先读已经有的东西。我的设计流程指南英文版把这一节放在共情阶段,并给出先做它的一个理由:成本最低。客服记录、销售数据、搜索记录、应用评论、过去的研究。你会知道该往哪里看,以及访谈的第一批问题。
Nielsen Norman Group 把更大的这一类叫作二手研究,也叫案头研究,并说它应该是任何严谨的研究工作的标准第一步。他们的说法很实际:如果别人已经做过这项研究,就拿来用,不要花钱重新发现你们自己的组织两年前就知道的事。
你可以用这种方式读两类数据。
你自己的数据,就是产品已经记录下来的东西:访问、转化流程、订单、客服收件箱、没人看的搜索框。离开就出现在这里:很多人到达、很少人往正确方向走的那一步。
公开数据,就是世界已经发布的东西:融资消息、竞品网站、应用商店评论、官方统计。《解构》用的就是这类数据。没有人给我们任何权限。我们读的每一页,任何访客都能打开。
两类数据的长处和限制都一样。它们记录发生了什么。它们不记录任何人的意图。
为什么要数,而不是问?
因为我的问题是一个”有多少”的问题,而人们不太会回答关于自己的这类问题。
如果我访谈十位创始人,问他们的阿拉伯语网站,我会听到十个版本的”我们支持阿拉伯语”。这是人们会说出口的话,也不是假话。对创始人来说,语言切换后面一个翻译好的首页就算支持。重要的问题是,这种支持对打开页面的人、对 Google、对 ChatGPT、Claude 和 Perplexity 背后的抓取程序来说是什么样子。这不是谁的看法。这是放在服务器上的事实,你可以直接去读。
这是在设计中使用数据的第一条规则。用它回答它能回答的问题:有多少、多常见、在哪里、从什么时候开始。用访谈回答它回答不了的问题:为什么、你当时想做什么、你原本以为会发生什么。
我们怎样选择要读什么?
大多数数据分析都跳过这一部分,而它决定结果有没有意义。
写这篇文章最容易的办法,是打开二十个我已经知道的新公司网站,找出有问题的,数一数。这能得到一个很好看的数字,却什么也证明不了。你找到的就是你去找的东西。
所以在打开任何网站之前,顺序就定好了。我们用一个公开来源,Wamda 的融资消息,按发布顺序从新到旧读:473 篇文章,从 2026 年 9 月 23 日到 2025 年 9 月 30 日。没有混入第二份名单,所以每家公司都来自同一份有顺序的消息。
标题只有报道了一家具名公司融资才符合条件:公开的一轮融资、战略投资或信用额度。基金、加速器、收购、退出、合作、产品发布,以及对同一家公司的重复提及,都不算。国家必须是这九个之一:Saudi Arabia、UAE、Egypt、Jordan、Kuwait、Qatar、Bahrain、Oman 或 Morocco。领域必须是金融科技、电商、配送、房产科技、医疗、教育、出行、软件或人力资源之一。有牌照的银行、官方机构,以及已知已经关闭的公司,都不算。
184 家公司通过了条件。我们按顺序检查,好网站坏网站都一样,直到有 100 家拥有阿拉伯语版本。第 100 家是 DOO,出自 Wamda 2025 年 9 月 30 日的文章。完整规则写在样本的选取方法里,和文章一起发布。
这段话里有三件事在起真正的作用。
来源在你之外。 公司不是我们选的。是 Wamda 选的,因为它报道了它们的融资。这把选择从我手里拿走了,当我对答案已有看法时,这正是它该在的地方。
停止规则事先定好。 “直到有 100 家拥有阿拉伯语版本”是一条你可以检查的规则。“直到我觉得够了”不是。
定义写了下来。 阿拉伯语版本指访客可以从公司自己的网站到达阿拉伯语页面文字:语言切换、hreflang 阿拉伯语链接、阿拉伯语默认首页,或者根据浏览器语言的跳转。只在手机应用里存在的阿拉伯语不算。没有任何链接指向的阿拉伯语网址也不算,切换后页面还是英语的语言按钮也不算。这些都是判断,它们写在说明里,你可以提出不同意见。
样本本身是一个简单的文件,sample.csv:公司、国家、领域、首页、阿拉伯语网址,以及把公司放进名单的那篇 Wamda 文章。100 行。每一行都能查到支持它的文章。
检查脚本到底查了什么?
检查脚本是一个文件,scan.mjs。文件开头的注释列出了它做的每一项检查,并说明了整个研究遵循的规则:每项检查都是测量,绝不猜测。
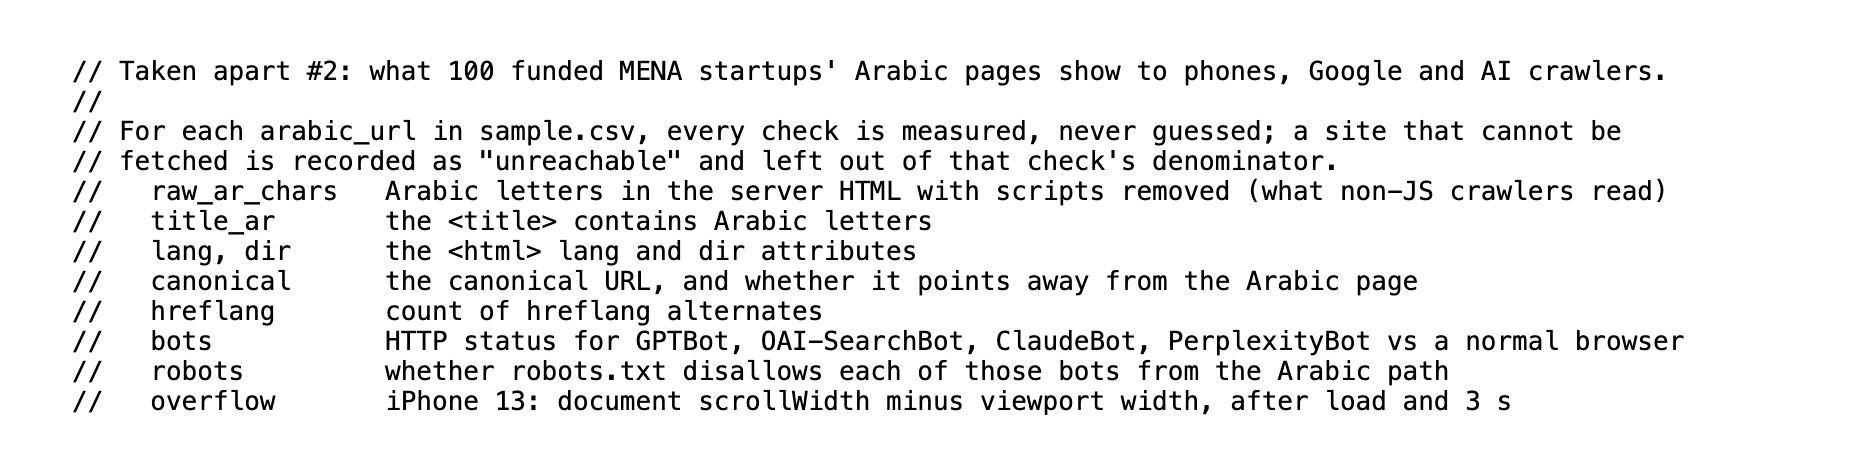
每项检查都代表一个读页面的人或机器。
| 检查 | 读取什么 | 代表谁 |
|---|---|---|
| raw_ar_chars | 去掉脚本后,服务器 HTML 里的阿拉伯语字母 | 不运行 JavaScript 的 AI 抓取程序 |
| title_ar | 页面标题是否含有阿拉伯语 | 用阿拉伯语搜索、在 Google 上看到那一行标题的人 |
| lang, dir | 页面设置的语言和方向 | 浏览器、读屏软件、搜索引擎 |
| canonical | 页面把自己还是另一个页面标为原始页面 | 决定显示哪个页面的 Google |
| hreflang | 页面声明了多少个语言版本 | 把阿拉伯语和英语页面配对的 Google |
| bots | GPTBot、OAI-SearchBot、ClaudeBot 和 PerplexityBot 得到的 HTTP 状态,与正常的浏览器对比 | ChatGPT、Claude 和 Perplexity |
| robots | robots.txt 是否不许上面每一个抓取程序读取 | 网站自己写明的规则 |
| overflow | 加载后页面在 iPhone 13 上左右移动多少 | 用手机的人 |
每次读取都优先要阿拉伯语,跟随跳转,25 秒后放弃。手机检查用 iPhone 13 的屏幕尺寸打开页面,等它加载,再等三秒,然后测量页面比屏幕宽多少。
我最在意的设计决定,听起来是最小的一个。无法读取的网站记录为无法到达,不计入那项检查的分母。它不算坏,也不算好。它算未知,而未知会写进结果。
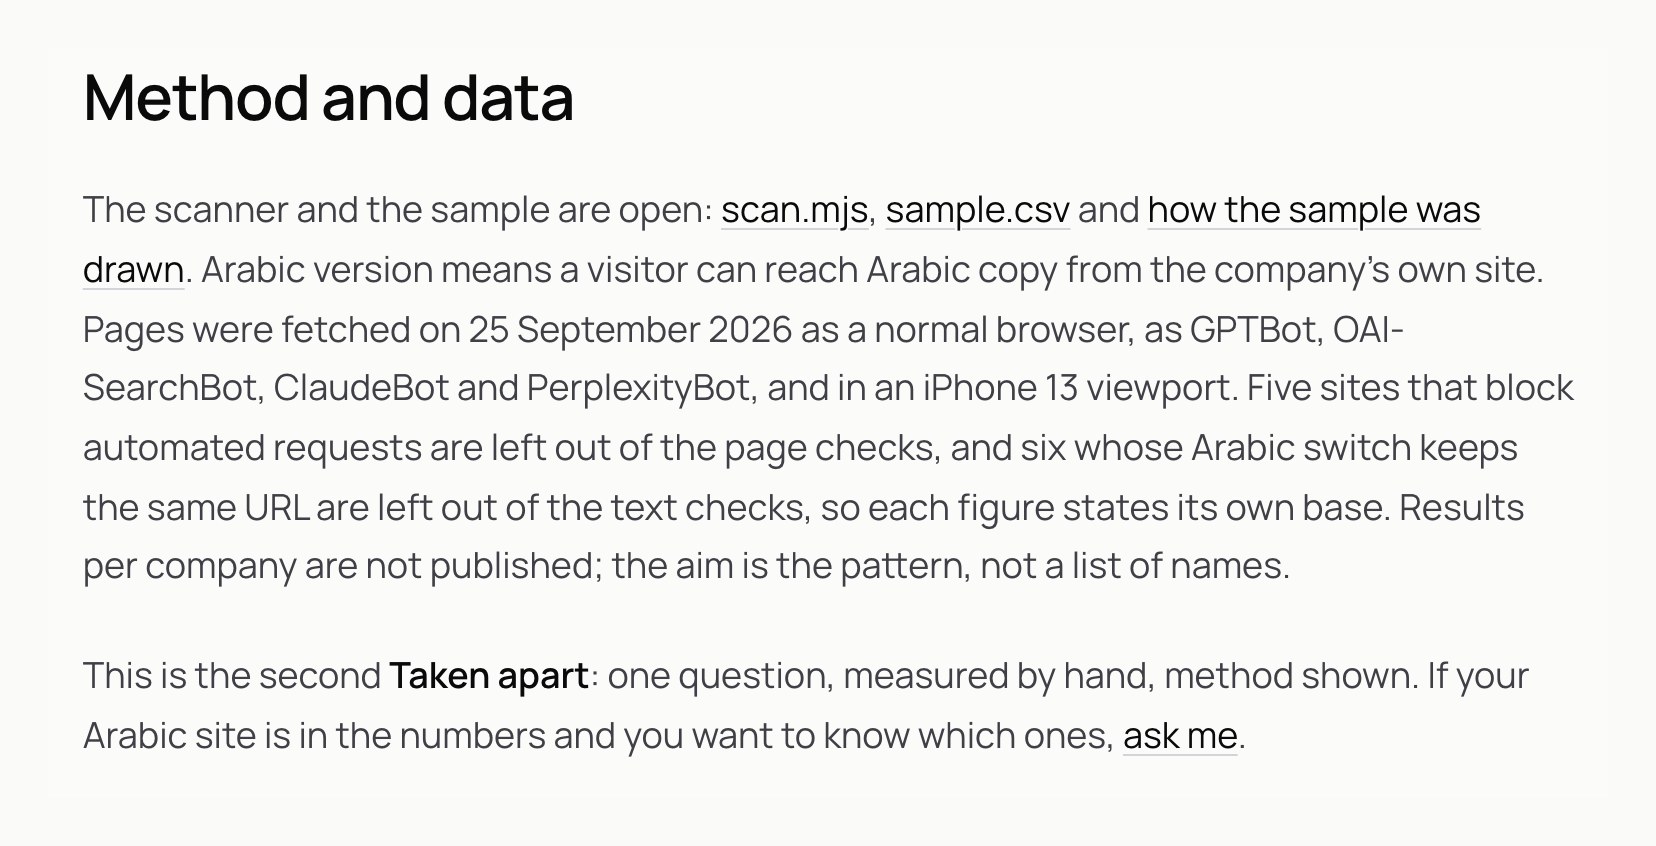
正是这一条规则,让文章可以说”在 88 个可以完整读取的阿拉伯语页面中”,而不是”在 100 个中”。那天有五个网站没有把页面交给检查脚本,四个拒绝,一个加载失败,所以它们不计入页面检查。每一个在核对样本时都能用阿拉伯语打开,所以它们留在样本里。另有七个不计入文字检查:文章提到的六个,它们的网址不随语言改变;还有一个把阿拉伯语画在 canvas 上,所以没有文字可读。基数变小了,而每个数字都说明自己用的是哪个基数:179 家公司,88 个页面,抓取程序检查用 94 个页面,手机检查用另外一组 94 个。
为什么每个数字都要带基数?
因为基数才是那个数字。没有基数的百分比只是一种情绪。
这是研究里的一个真实例子。文章说 179 家公司中有 79 家没有阿拉伯语版本,44%。同一天发布的样本说明说,184 家中有 79 家有可用网站但没有阿拉伯语版本,43%。同样的 79 家公司。两个不同的百分比。
两个都对。184 是通过条件的全部公司。其中四家我们找不到网站,一家没有计入,因为它的网站在我们所在地点阻止了我们,所以无论哪种情况都没法检查。去掉这五家,就是我们真正能判断的 179 家。除以 184,基数里留着五家我们从没判断过的公司。除以 179,说的只是我们看到的。
UAE 也一样。文章说 67 家中有 53 家。样本说明说 69 家中有 53 家。差别是两家我们找不到网站的 UAE 公司。同样的 53 家,不同的基数,两个都对,其中只有一个说的是网站。
如果我们只印”44%“,没有人会注意到这两处差别。问题正在这里。单独一个百分比,把它背后的每个决定都藏了起来。基数把决定放回页面上,读者可以提出不同意见。
所以,无论是研究报告、数据面板还是融资演示,要带走的规则是:先写数量,再写基数,最后写百分比。“179 家中的 79 家,44%“。如果前两个填不上,你就没有第三个。
样本和结果对得上吗?
发布之前有一个好习惯:像陌生人那样,拿已发布的文件核对已发布的说法。
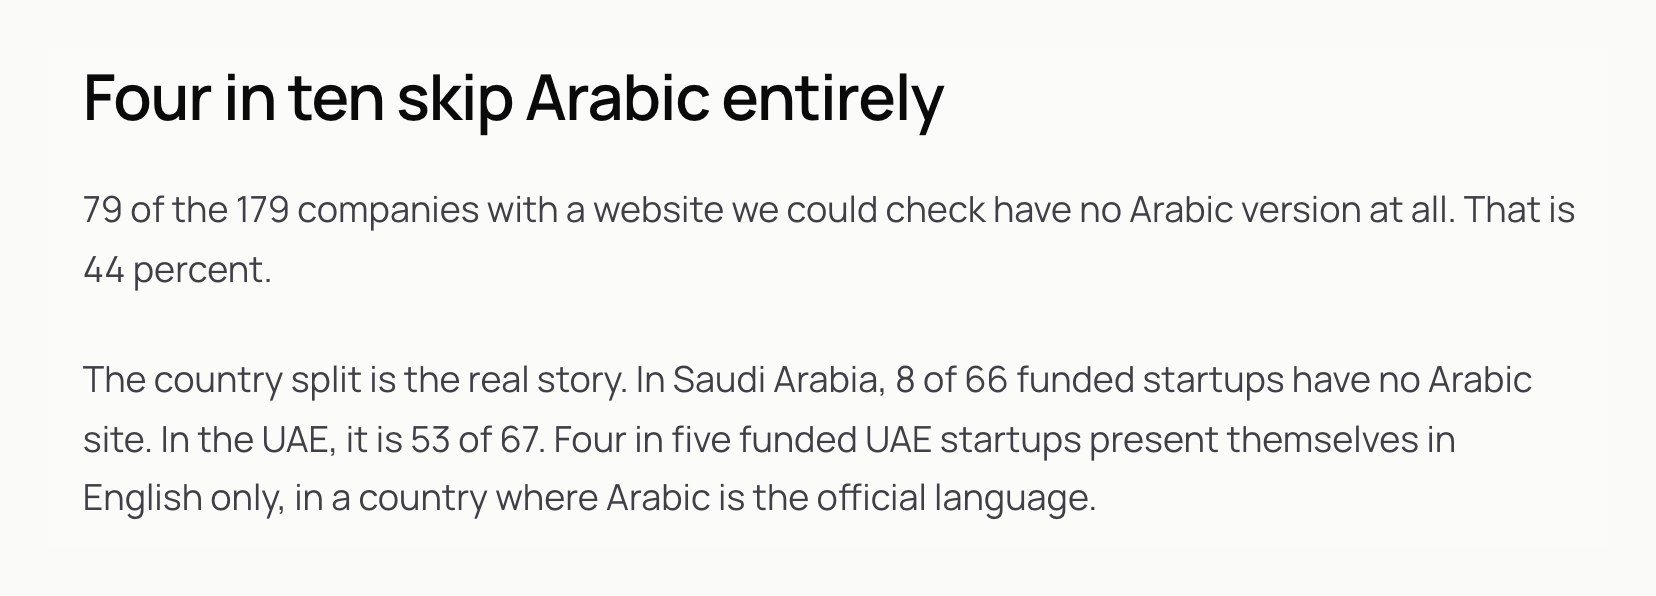
文章说 66 家获得融资的 Saudi Arabia 新公司中有 8 家没有阿拉伯语网站,所以 58 家有。数一数 sample.csv 里 Saudi Arabia 的行,是 58。文章说 67 家 UAE 新公司中有 53 家没有阿拉伯语网站,所以 14 家有。样本里 UAE 的行:14。文件和文章一致,谁都可以在一分钟内查完。
样本也显示了被数对象的样子。100 家公司中,28 家是金融科技,22 家是软件,14 家是电商。58 家来自 Saudi Arabia。用这份数据说”中东北非新公司”,实际上说的都偏向 Saudi Arabia 的金融科技和软件。领域分布反映的是那一年谁融到了钱、谁被报道。Saudi Arabia 的比重则来自样本自己的规则:名单里 UAE 和 Saudi Arabia 的公司差不多一样多,67 家和 66 家,但只有拥有阿拉伯语网站的公司才能进入样本。这不是方法的缺点。这是文件里有谁的事实,你要把它说出来,不要让读者以为样本看起来就像整个地区。
文件还显示了一件小事:100 行中有 32 行,阿拉伯语页面和首页是同一个地址。有时这是阿拉伯语默认首页。有时是语言切换只改文字、不改网址,这正是那次统计不得不从文字检查中去掉的情况。文件告诉不了你是哪一种。你得打开网站。
数据到底发现了什么?
在 88 个可以完整读取的阿拉伯语页面中,42 个至少有一个问题,让阿拉伯语内容远离搜索或 AI 回答。即 48%。
- 28 个没有 hreflang,32%。Google 不知道阿拉伯语页面和英语页面是同一内容的两种语言。Google 在关于本地化版本的文档中解释了 hreflang 怎样配对语言版本。
- 23 个在阿拉伯语页面上用英语标题,26%。
- 9 个在 JavaScript 运行之前页面里没有阿拉伯语,10%。对读取原始页面的抓取程序来说,这个阿拉伯语网站是空的。
- 抓取程序检查的 94 个页面中,8 个直接拒绝 AI 抓取程序,返回错误,9%。八个里只有一个在 robots.txt 里写明了这一点。
- 3 个把 Google 指向英语页面作为原始页面,3%。
人们通常怀疑的手机排版,大多没有问题。94 个页面里只有 4 个在 iPhone 上会左右移动。
最后这一行就是要去数的理由。数出来的结果把问题放到了别处,放到了没人看见的地方:一个标题标签、一个 link 元素、一条服务器规则。数据分析最好的时候,是它证明你看错了地方。
数据在哪里停下?
看那八个拒绝 AI 抓取程序的网站。数据很准确:抓取程序要页面,服务器返回错误,正常的浏览器能拿到页面。八个里只有一个在 robots.txt 里写明了这一点。
它告诉不了你的是,有没有人选择了这样做。文章说,其余七家是服务器规则,并不是谁做出的决定。这是对证据最合理的解读:你有意做的决定会写进 robots.txt,你从没看过的默认设置留在服务器规则里。但这仍然只是解读。状态码是数据。它背后的意图是推断,要把它变成事实,唯一的办法是去问那家公司。
UAE 的数字也一样。67 家获得融资的 UAE 新公司中有 53 家没有阿拉伯语网站。你可以想象原因。他们的买家是外国人。他们的投资人读英语。阿拉伯语在计划里。我们没有问过。每一种原因都会带来不同的设计决定,而数据把它们都当成同一行。
NN/g 关于定性和定量研究的比较用一句话说清了:定量数据可以告诉你一个设计可能行不通,但不会指出用户碰到了什么问题,也不会告诉你该改什么。这正是那篇文章的限制。它以一个提议结束,“如果你的阿拉伯语网站在这些数字里,想知道具体是哪些问题,告诉我”,因为数完之后的下一步总是一次对话。
怎样在自己的产品里看人们在哪里离开?
《解构》的检查用的是公开数据。设计中的大多数数据分析用的是你自己产品的数字,形式是一样的。
这样的流程是离开数据最常见的形式。每一步列出有多少人到达。人数掉得最多的那一步,就是你先看的地方。
我是这样做的。
- 打开数据面板之前先写下问题。“卖家的顾客在购物车和付款之间的哪里离开?“是一个问题。“我们来看看分析数据”是白白花掉一个下午的办法。
- 定下时间范围和来源。一个日期范围,一个数据来源,在看之前选好。不断改范围直到图表看起来有意思,就是数据面板版的挑二十个你已经知道的网站。
- 为每一步写下数量和基数。不是”结账不好”。而是”这个月到达结账的人里,有这么多人付了款”。
- 找最大的一次下降,不是每一次下降。每个流程的每一步都有人离开。要研究的是离开人数最多的那一步。
- 读它背后的原始数据行。打开那一步真实的访问、真实的订单、真实的工单。平均值藏起了试了三次的那个人。
- 停下来,写下访谈问题。数据分析的产出不是一个修复方案。而是一份简短的名单:要和谁谈,问什么。
第六步是人们会跳过的。流程说很多人在结账时离开。它没有说是配送费让他们意外、付款方式不存在、页面语言不对,还是他们只是在比价。每一种都是不同的界面。不问就选一个,你就是在为自己的猜测做设计,再配一张图表让它看起来像研究。
你该怎样对待”为什么”?
去向人们要答案。
在 Wfrah,我们为海湾地区绵羊和山羊养殖户设计的应用,牧民说出口的都是同一个答案:饲料太贵,买家给得太少。如果你只数人们说了什么,这就是你的发现。访谈发现了这句话底下的东西。很多牧民没法用公式算出畜群每天的营养需要,而把亏损归咎于市场,让他们很容易忽视营养和管理。所以应用里有一个替他们完成计算的营养计算器。
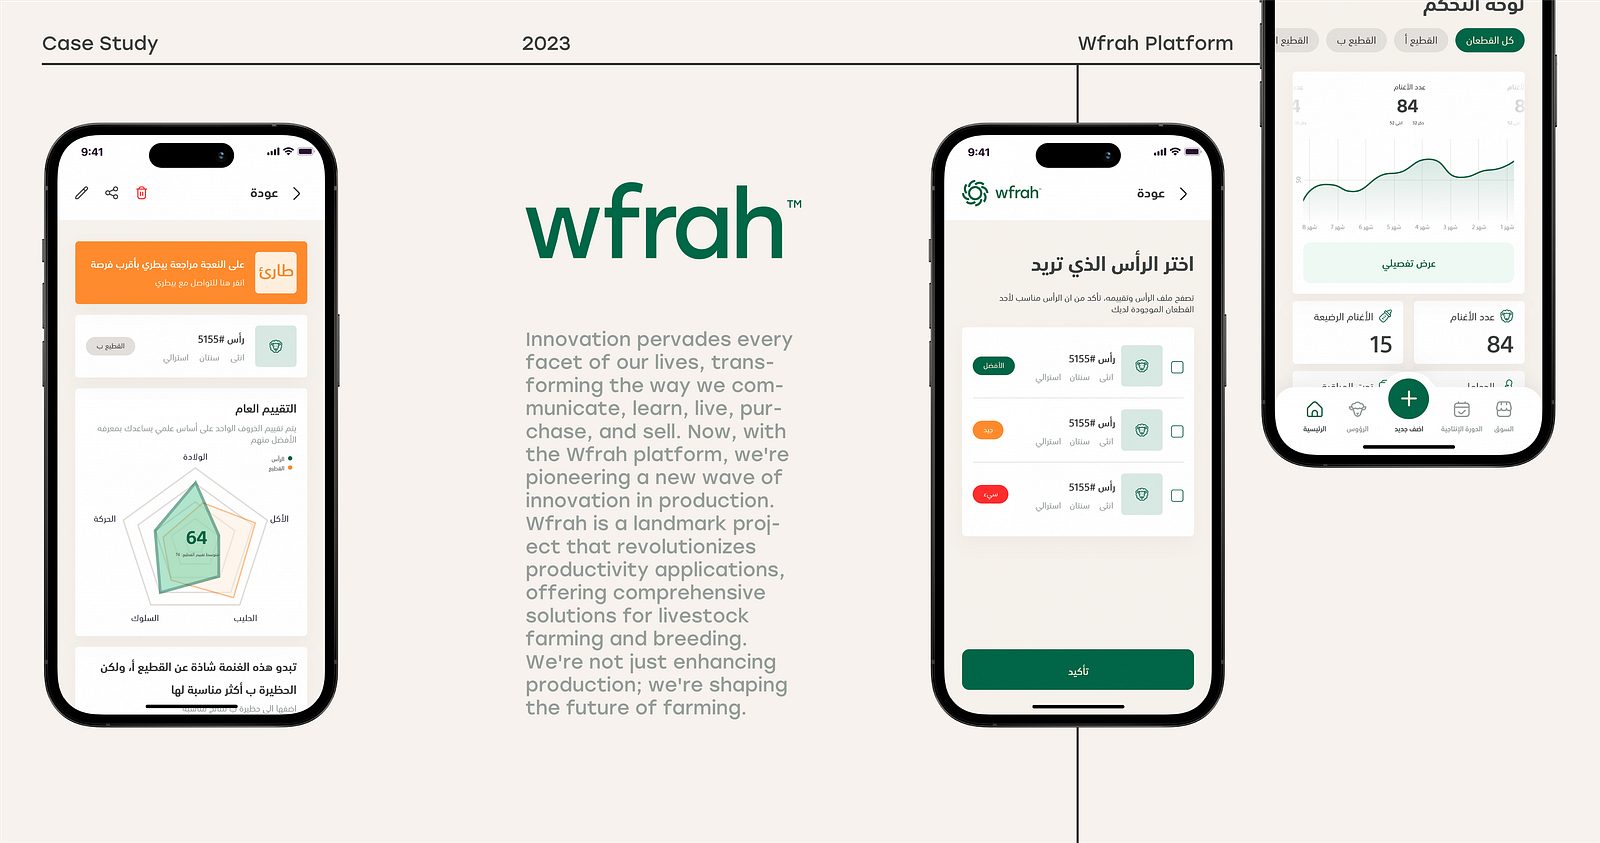
工作顺序很简单。数据分析找到在哪里,并量出大小。访谈找到为什么。根据数据写的用户访谈脚本,问这个人上一次走到那一步的经过。亲和图整理他们说的话,每张便签都带参与者编号,这样每个主题都能查到是谁说的。然后问题陈述说明你要解决什么、为谁解决,用数据里的数量作为规模的证据。
怎样用 AI 做数据分析,又不让自己上当?
AI 让这个方法便宜了很多。模型一分钟读完一千条应用评论,把客服工单按主题分类,写好抓取脚本,起草报告。工具变得很快。2026 年 10 月的 Show HN:Graphene,一个给编程 agent 用的数据分析工具包,把这个开放的问题说得很清楚。开发者问,编程 agent 现在能不能做完一个 BI 团队的大部分工作,他们的回答是:差不多。他们还需要一个上下文层,“to ensure query correctness”,也就是确保查询正确。
正确才是全部。查询稍微写错的模型,照样交给你一张很有把握的图表。让模型总结研究,它会很轻易地写出”大多数用户”,或者一个不知从哪里来的整数百分比。结果看起来完成了,而完成不等于正确。
让《解构》保持诚实的不是更聪明的模型。而是一组让工作可以检查的规则,它们适用于 AI 碰过的任何分析。
让它写代码,不是写结论。检查脚本是一个读取页面、记录所见的文件。它什么也不决定。向模型要那个负责数的脚本,然后自己运行。脚本可以重读、重跑。一段话不行。
让它记录未知。“measured, never guessed”写在检查脚本最开头的几行,是有原因的。如果模型用一个可能的值填上缺失的值,你的结果就一部分是数据,一部分是虚构,而你分不清是哪一部分。
每个数字都要基数。AI 写的摘要里的任何百分比,都要回答两个问题:总数是多少,出自哪个文件。两个答不上来,就删掉。听起来对的数字也不例外。
自己打开原始数据行。相信一个主题之前,读五条里面真实的评论。相信一个数字之前,打开三个被数到的网站。《解构》的样本通过了这项检查:CSV 里 Saudi Arabia 和 UAE 的数量和文章一致。
把顺序和停止规则留在模型之外。不该由模型决定读哪些记录、什么时候停。这是方便的结果最容易混进来的地方,而这个决定是你的。
发布数字就发布方法。检查脚本、样本和样本说明都在文章旁边。这是最强的检查。如果我错了什么,谁都能发现。
这件事的另一半,我写在 AI 能取代用户研究吗里:模型很会起草、整理和列出,却当不了你的用户。数据分析是它最有用也最危险的地方,因为产出是数字,而人们不读就相信数字。
什么时候不该从数据开始?
还没有东西可读的时候,或者手上的数据数错了东西的时候。
没有产品的新想法,没有访问可以分析。公开数据仍然有帮助:竞品网站、最接近的产品的评论、人们在交流区里用的说法。但主要的研究是访谈,不要等不存在的数字。
六份调查回答只是线索,不是发现。不要算出精确到小数的平均值,再当结果展示。说出它们让你想到什么,然后去问。
指标可能跟踪了错误的结果。点击、页面停留时间和访问,都可能因为页面让人困惑而上升。如果你的数据奖励错误的行为,更多分析只会让问题看起来更精确。先决定用户想完成什么,再选跟踪它的数字。
人们写的语言,你的工具可能读不好。带方言、混合文字和用阿拉伯字母写的英语的阿拉伯语评论,工具很难分类,除非你自己读,否则看不到错误。这也是《解构》只数机器能准确读取的东西的一个原因,阿拉伯语字母和状态码,并避开任何需要模型猜测意思的东西。
下一次会是什么样?
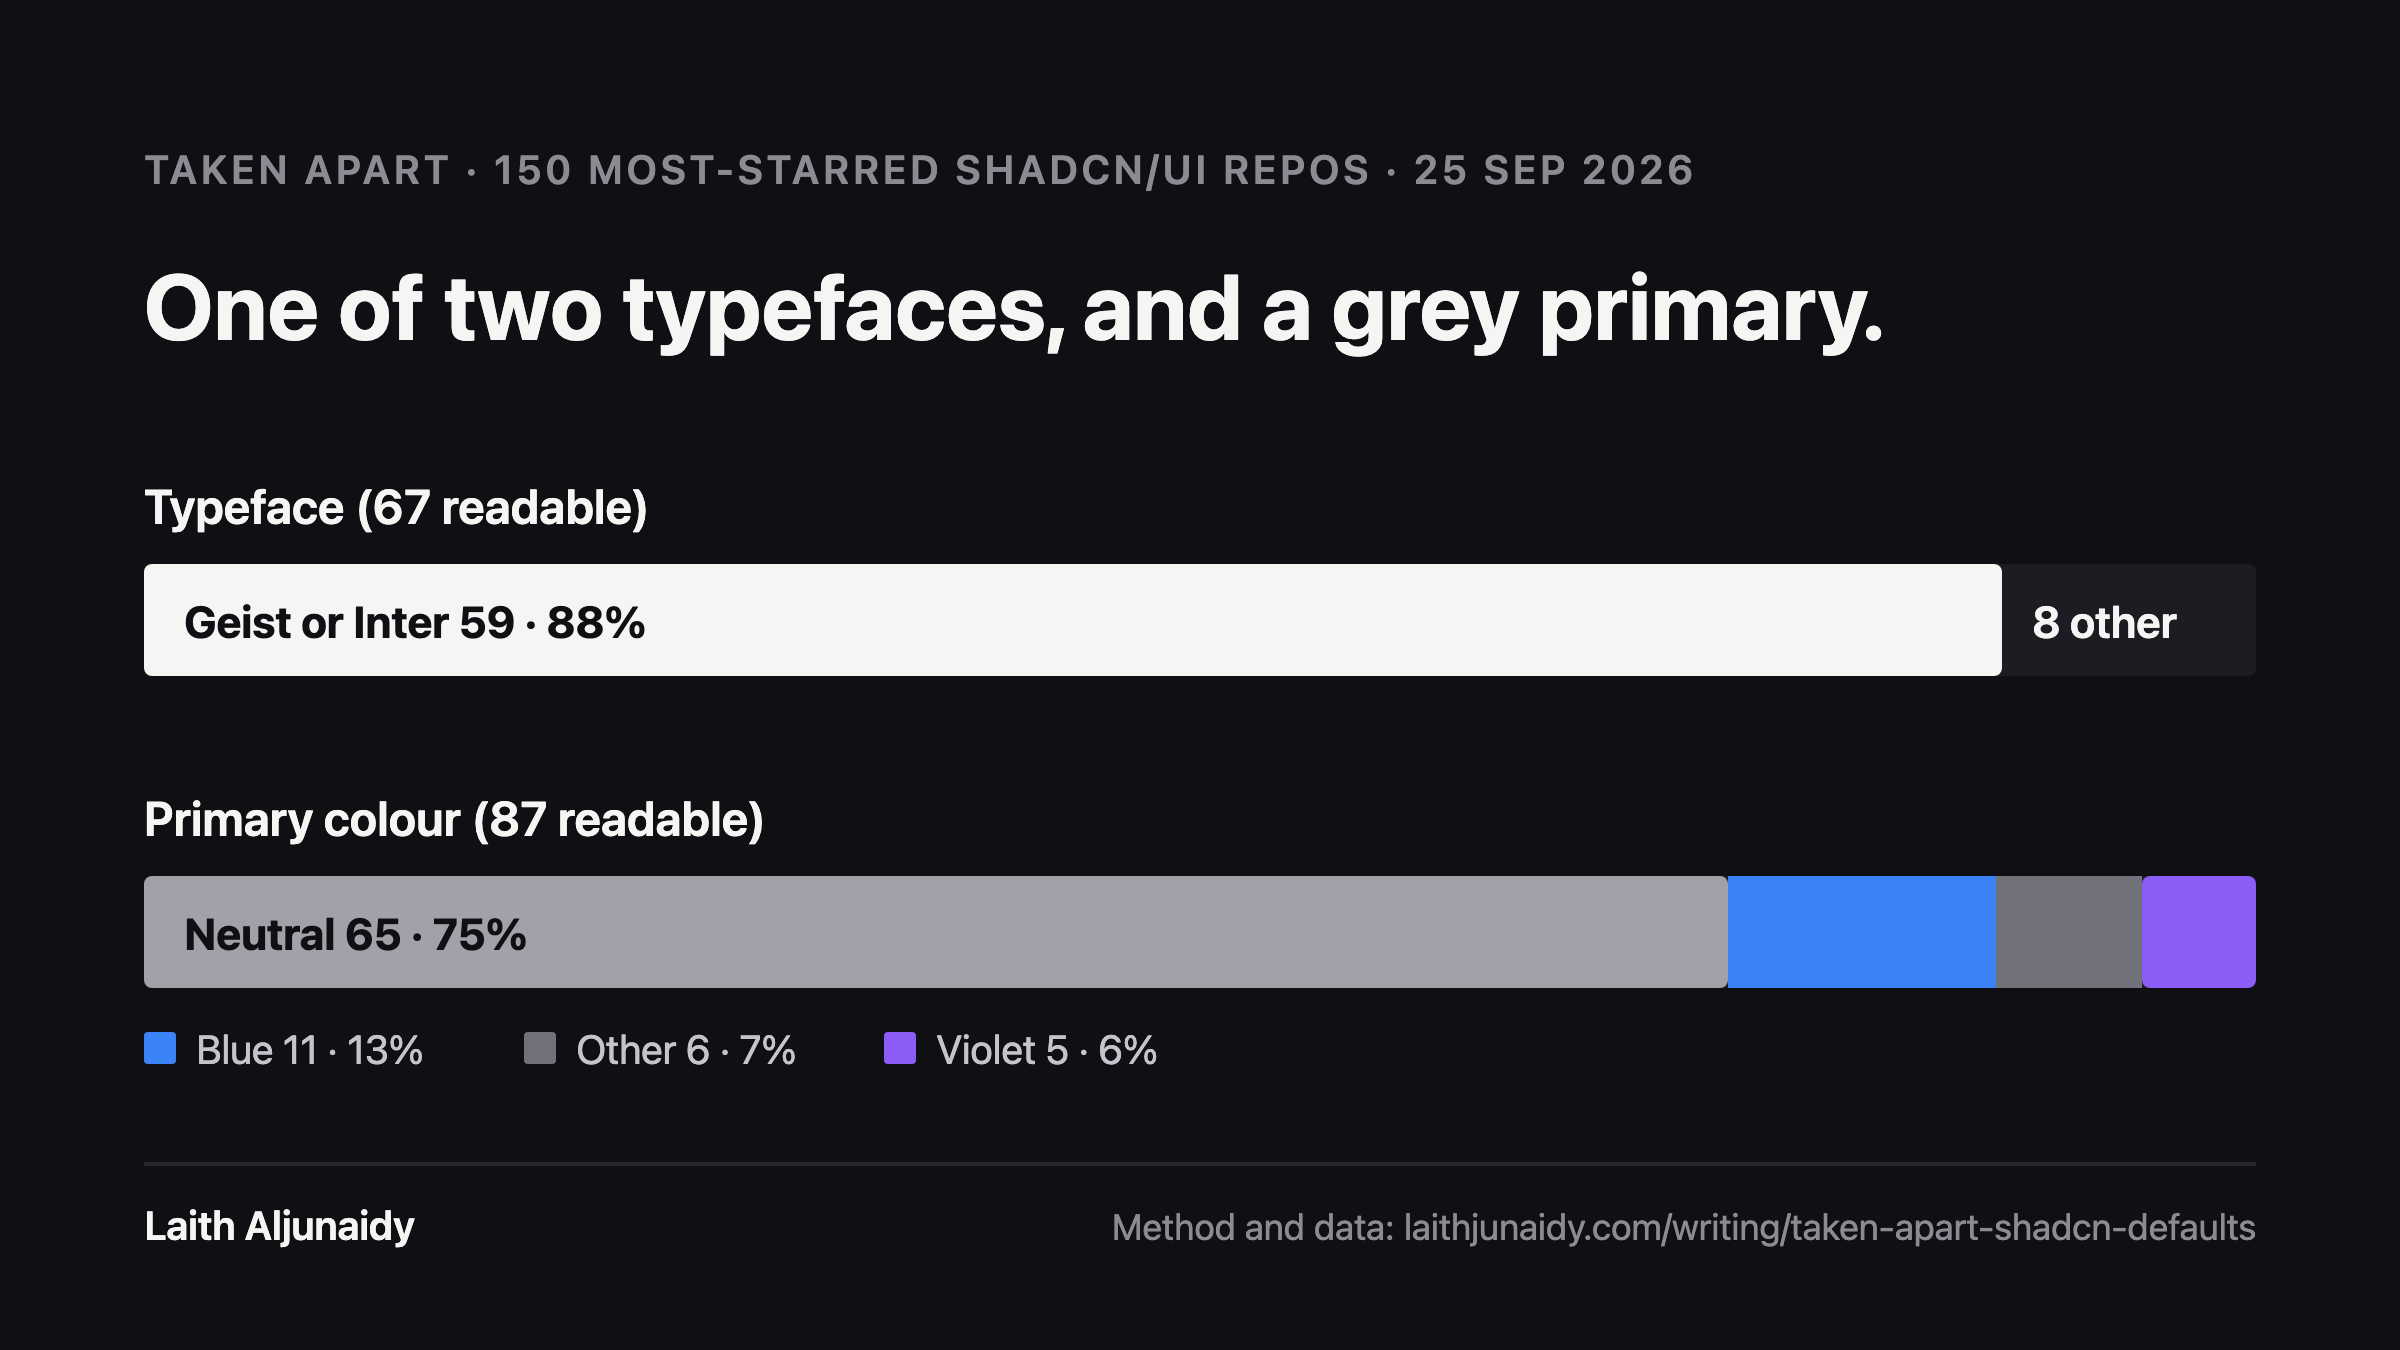
这个方法在任何规模都适用。《解构》第一期用的是 GitHub,不是网站:收藏数最多的 150 个 shadcn/ui 仓库,从代码里读取字体和主色。读不出信号的仓库算作无法读取,绝不猜测,这样留下 67 个可以读出字体的仓库。这 67 个中有 59 个使用 Geist 或 Inter。同样的规则,不同的来源。
如果你想做自己的版本,顺序是:
- 一个可以用数量回答的问题。
- 一个来源,按固定顺序读,写明什么符合条件。
- 事先定好的停止规则。
- 在第一条记录之前写好的定义。
- 一个会测量并记录未知的检查脚本或查询。
- 每个结果都写成数量、基数、百分比。
- 拿已发布的文件核对已发布的说法。
- 方法和样本发布在数字旁边。
- 一份你现在需要去问为什么的人的名单。
最后一步把分析变成设计。数出来的结果告诉你,67 家获得融资的 UAE 新公司中有 53 家只用英语。这不需要任何权限,也不需要任何人同意。弄清为什么要靠对话,而原因会决定该做什么。
常见问题
UX 中的数据分析是什么?
在研究或设计任何新东西之前,先读已经有的东西:分析数据、转化流程、销售、客服记录、搜索记录、应用评论和公开数据。它显示人们在哪里离开、影响了多少人。这是成本最低的研究方法,所以排在最前面,它的结果是访谈问题,不是修复方案。
数据分析和二手研究有什么区别?
两者有重叠。二手研究,也叫案头研究,是收集别人已经发现的东西:报告、研究、过去的研究。数据分析是自己读原始记录,你自己产品的数字或公开数据,然后数某样东西。《解构》是在公开数据上做的数据分析:一份融资消息,按顺序读,再用检查脚本检查 100 家公司的阿拉伯语页面。
数据能告诉你用户为什么离开吗?
不能。数据显示人们在哪里离开、有多少人。它显示不了他们想做什么、什么让他们困惑、他们原本期待什么。NN/g 说的是同一件事:定量数据可以告诉你某样东西行不通,但不会告诉你用户碰到了什么问题,也不会告诉你该改什么。用数据来决定访谈谁、问什么。
怎样用 AI 分析用户反馈?
把原始反馈给模型,要它给出主题,每一条都标明来源,再要它给出带基数的数量。然后自己读每个主题里五条真实内容,删掉任何没有数量、没有文件的百分比,把结果当作访谈问题。AI 分类很快。它不是事实的来源。
样本需要多大?
大到足够回答问题,并且在看之前定好。《解构》事先定了规则:按顺序检查每一家符合条件的公司,直到有 100 家拥有阿拉伯语版本,这一共用了 184 家公司。六份调查回答这样很小的样本也有用,但只是去找人谈的理由,不能单独成为发现。
为什么要公开检查脚本和样本?
因为没人能检查的数字只是说法,不是发现。公开 scan.mjs、sample.csv 和样本的选取方法,意味着谁都可以重新跑这项研究、找出错误或者扩展它。每家公司的结果没有公开。目的是呈现规律,而不是一份名单。
参考来源
- 二手研究 nngroup.com
- 融资消息 wamda.com
- 本地化版本 developers.google.com
- NN/g 关于定性和定量研究的比较 nngroup.com
- Show HN:Graphene news.ycombinator.com